Surveiller arXiv avec OpenClaw : Cas Réel Research
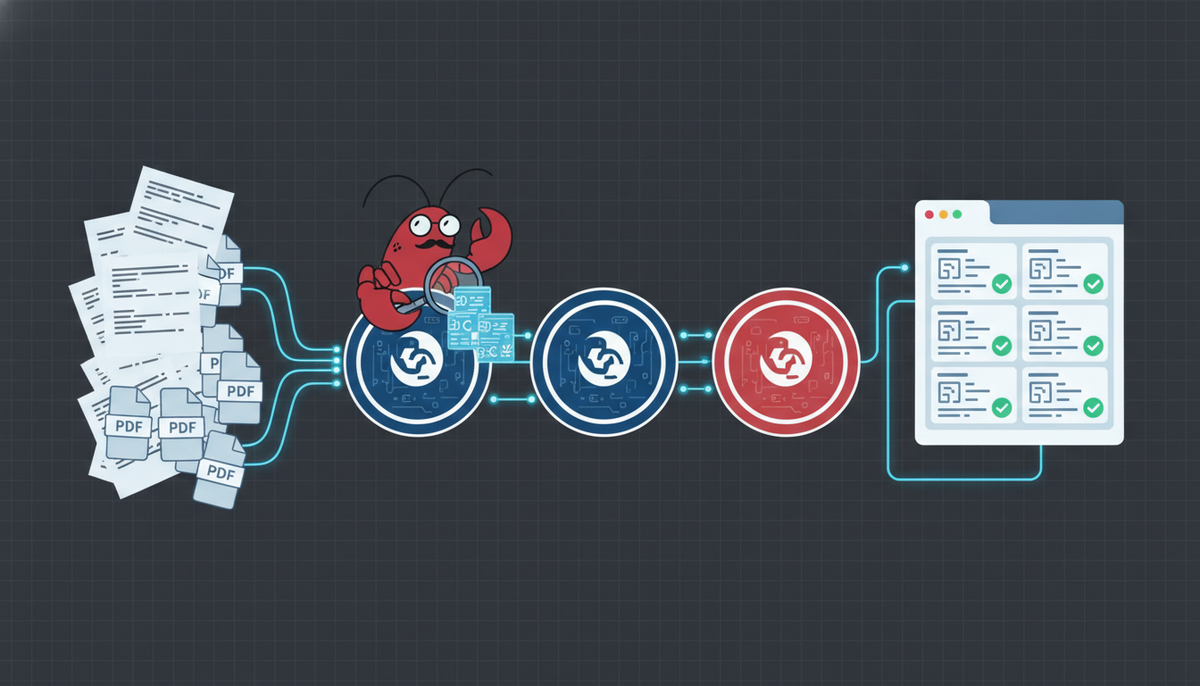
Avant : des PDFs arXiv éparpillés. Après : un rapport HTML vérifié chaque jour. Comment Sconcer a structuré sa veille recherche avec OpenClaw.

Bon dimanche ! ☕
Aujourd'hui, on plonge dans un cas qui parle à tous les lecteurs qui font de la veille sérieuse : suivre arXiv sans finir noyé sous les PDFs, les onglets et les résumés trop rapides. Le projet s'appelle Daily Paper Brief, il est public, récent, et surtout très documenté : monitor, pipeline, skill, cron OpenClaw, validation, sécurité, tout est exposé.
Ce n'est pas un petit script “résume-moi trois papiers”. C'est une vraie chaîne de production de rapports de recherche, avec une obsession saine : chaque résumé doit rester rattaché à ses sources, chaque étape doit produire un artefact vérifiable, et l'envoi final ne doit partir que si les garde-fous passent.
🎯 Le Cas : Veille arXiv avec rapport vérifiable
Auteur : Sconcer
Source : Daily Paper Brief
Contexte : un workflow de veille recherche pour transformer un flux arXiv quotidien en rapport HTML lisible, principalement en chinois, avec preuves et validation.
Objectif : automatiser la sélection, la préparation, la revue structurée et la livraison d'un briefing de papiers scientifiques sans perdre la traçabilité.
📖 L'Histoire
Le problème de départ est très concret : arXiv produit beaucoup plus de signal qu'un humain ne peut en lire chaque matin. Même avec un bon filtre RSS, il reste plusieurs tâches pénibles : choisir les papiers pertinents, récupérer les PDFs, extraire les figures, lire les sections importantes, distinguer ce qui est démontré de ce qui est seulement affirmé, puis produire un rapport assez propre pour être relu ou partagé.
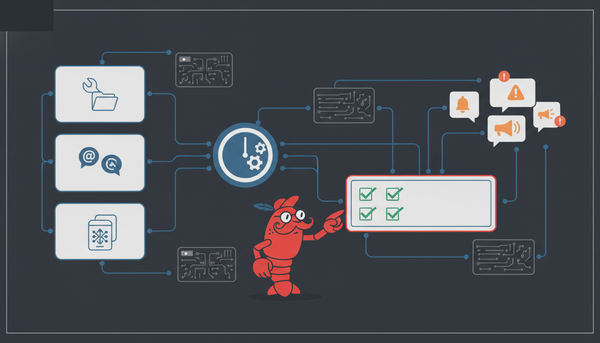
Daily Paper Brief part d'une idée simple : le modèle ne doit pas être le centre du système. Le centre, c'est le pipeline. Le dépôt décrit cinq étapes nettes : monitor, prepare, review, gate, deliver. D'abord, un script récupère et classe les papiers arXiv selon des profils de sujets. Ensuite, un autre prépare les sources : PDFs, texte extrait, figure principale, manifeste de provenance, template de revue. L'agent OpenClaw intervient surtout au moment de la revue, dans un cadre très borné, puis une validation déterministe reconstruit le rapport final.
Ce détail change beaucoup de choses. Dans un workflow plus naïf, on demanderait à l'agent de “faire la veille” et on accepterait un Markdown final. Ici, l'auteur force OpenClaw à passer par des fichiers intermédiaires. Le rapport n'est valide que si reviews.json respecte le contrat, si le HTML se construit, si le reçu de build correspond, puis si le dry-run de livraison passe.
Le dépôt a été publié le 3 septembre 2026 et son README annonce un statut “source-ready for owner review”. La validation documentée mentionne une CI GitHub passée, des tests unitaires offline, un audit de sécurité local, et des probes réseau arXiv réussies. On reste donc sur un projet jeune, mais avec une discipline de publication beaucoup plus forte que la moyenne des exemples d'agents.
🔧 Le Setup Technique
Architecture Agent
Le workflow ressemble à une petite chaîne CI appliquée à la veille scientifique :
arXiv API/RSS
  -> monitor Python : sélection + déduplication
  -> prepare Python : PDFs, texte, figures, provenance
  -> OpenClaw : revue structurée par lots bornés
  -> gate Python : merge, validation JSON, build HTML
  -> sender Python : dry-run puis livraison Feishu
OpenClaw n'est pas seul dans la boucle. Il est entouré par des scripts déterministes qui limitent ce qu'il peut casser. Le cron fourni demande même de traiter les lots par groupes de trois papiers maximum, de collecter les batchs, puis de bloquer jusqu'à ce que tous les IDs attendus soient présents.
Fichiers Clés
SKILL.md
name: daily-paper-brief
description: 每日论文简报流水线。监控 arXiv 当日新论文,
准备来源证据,组织结构化中文评审,逐字段校验后构建单文件离线 HTML 报告。
Cron OpenClaw
python3 scripts/install_openclaw_cron.py --render-only
python3 scripts/install_openclaw_cron.py --apply --acknowledge-local-agent-trust
Commandes de base
python3 scripts/setup_config.py --list
python3 scripts/setup_config.py --profile ai-infra-hpc
./scripts/bootstrap.sh
.venv/bin/python src/arxiv_monitor_phd.py
.venv/bin/python src/arxiv_report_pipeline.py prepare --input ./papers_to_expand.json --date YYYY-MM-DD
Étapes de Mise en Place
- Cloner le dépôt et vérifier l'environnement : Python 3.12 ou plus récent, Poppler disponible, accès réseau arXiv si on veut lancer la veille réelle.
- Lancer
./scripts/bootstrap.shpour créer.venv, installer les dépendances verrouillées, générer une configuration locale et exécuter les checks offline. - Choisir un profil via
scripts/setup_config.py. Le dépôt fournit notammentai-infra-hpc,nlp-llm,vision-robotics,security-privacyetscience-computing. - Configurer les variables nécessaires à la livraison si Feishu est utilisé :
FEISHU_CHAT_ID,ARXIV_REVIEW_MODEL,DAILY_PAPER_BRIEF_USER_AGENT. - Rendre le cron OpenClaw avec
--render-only, inspecter les fichiers runtime, puis appliquer explicitement avec--acknowledge-local-agent-trust. - En production, considérer la sortie valide uniquement si le rapport HTML est construit, le dry-run passe, et l'envoi retourne un message ID ou un skip idempotent documenté.
📊 Les Résultats
Gains mesurés ou observables :
- 5 profils de sujets prêts à l'emploi pour éviter de réécrire toute la logique de sélection.
- 1 rapport HTML offline par journée de veille, avec manifeste de sources, figures, reçus de build et revue structurée.
- 401 hashes de distributions PyPI verrouillés dans
requirements.lock, d'après le dossier de validation. - CI GitHub passée sur le commit initial public, avec tests unitaires offline et audit de sécurité documentés.
Limites rencontrées :
- Le gain de temps humain n'est pas chiffré par l'auteur : on voit la réduction de tâches manuelles, pas une métrique “avant/après” en heures.
- La livraison Feishu suppose un environnement privé correctement configuré.
- Le pipeline garde
execdans le job OpenClaw, ce que l'auteur documente comme un risque résiduel. - Les droits sur PDFs, figures et contenus scientifiques restent à vérifier avant toute redistribution publique.
🧐 Analyse Critique
✅ Ce qui est bien fait
- La séparation des responsabilités est excellente. Python récupère, prépare, valide et livre ; OpenClaw lit et produit une revue structurée. L'agent fait ce qu'il sait faire, mais ne remplace pas les contrôles.
- Le dépôt traite les sources comme non fiables. PDFs, HTML, pages auteurs, repos et contenu de papiers sont explicitement considérés comme des entrées non sûres. Pour un agent de veille, c'est indispensable.
- La notion de “succès” est stricte. Un retour normal de l'agent ne suffit pas. Il faut des artefacts complets, un build, un reçu, puis un dry-run de livraison.
⚠️ Points d'attention
- Ce setup est plus proche d'une mini-plateforme que d'un script personnel. Pour un lecteur moyen, la première installation demande de comprendre les profils, la config locale, le runtime OpenClaw et les credentials Feishu.
- L'évaluation “AI-writing-signals” est intéressante, mais sensible. Le dépôt insiste sur le fait qu'elle ne prouve ni l'auteur, ni la fraude, ni le plagiat. Il faut garder cette nuance partout où le rapport est partagé.
- L'isolation OpenClaw n'est pas une sandbox OS. Le dépôt le dit clairement : en multi-utilisateur, il faudrait séparer retrieval, review, rendu et livraison dans des utilisateurs ou conteneurs distincts.
💡 Améliorations possibles
- Ajouter un exemple de rapport anonymisé complet aiderait à comprendre la sortie finale sans lancer toute la stack.
- Documenter une variante “local only”, sans Feishu, rendrait le projet plus accessible aux équipes qui veulent juste générer un HTML quotidien dans un dossier partagé.
🎓 Ce qu'on en retient
Leçons clés :
- Un bon agent de veille n'est pas seulement un prompt. C'est un pipeline avec entrées, artefacts, validation et critères de succès explicites.
- La reproductibilité vient souvent de fichiers intermédiaires ennuyeux : manifestes, templates, batchs JSON, reçus de build. C'est moins glamour qu'un chat magique, mais beaucoup plus fiable.
- OpenClaw devient puissant quand on lui confie une étape cognitive précise, pas quand on lui donne toute la production sans garde-fou.
Pour aller plus loin :
- Automatiser sa Recherche ML avec OpenClaw : Cas Réel Research
- Construire sa Mémoire Obsidian avec OpenClaw : Cas Réel Research
- Source originale
À dimanche prochain pour un nouveau cas !