Compiler 216 sources avec OpenClaw : Cas Réel Média
draco-agent centralise 216 sources de veille dans un digest OpenClaw. Pipeline, scoring, limites API et garde-fous éditoriaux : le cas complet.
Bon dimanche ! ☕
Une veille utile ne consiste pas à empiler des liens : elle consiste à repérer le signal, expliquer pourquoi il compte, puis laisser le lecteur décider. Cette semaine, on décortique un workflow OpenClaw open source qui automatise cette partie ingrate — sans prétendre remplacer le jugement éditorial.
🎯 Le Cas : un digest tech multi-source, livré chaque matin
Auteur : draco-agent
Contexte : mainteneur d’un skill OpenClaw distribué en open source (licence MIT).
Objectif : agréger une veille technique hétérogène, dédupliquer les informations et livrer un digest configurable dans Discord, par e-mail ou en PDF.
📖 L’Histoire
Le problème est familier : les sources utiles sont dispersées entre flux RSS, dépôts GitHub, comptes X, résultats de recherche et, parfois, Reddit. Les consulter l’une après l’autre prend du temps ; les agréger sans règle produit surtout un bulletin de liens. Le projet Tech News Digest de draco-agent formalise ce travail dans un skill installable par OpenClaw.
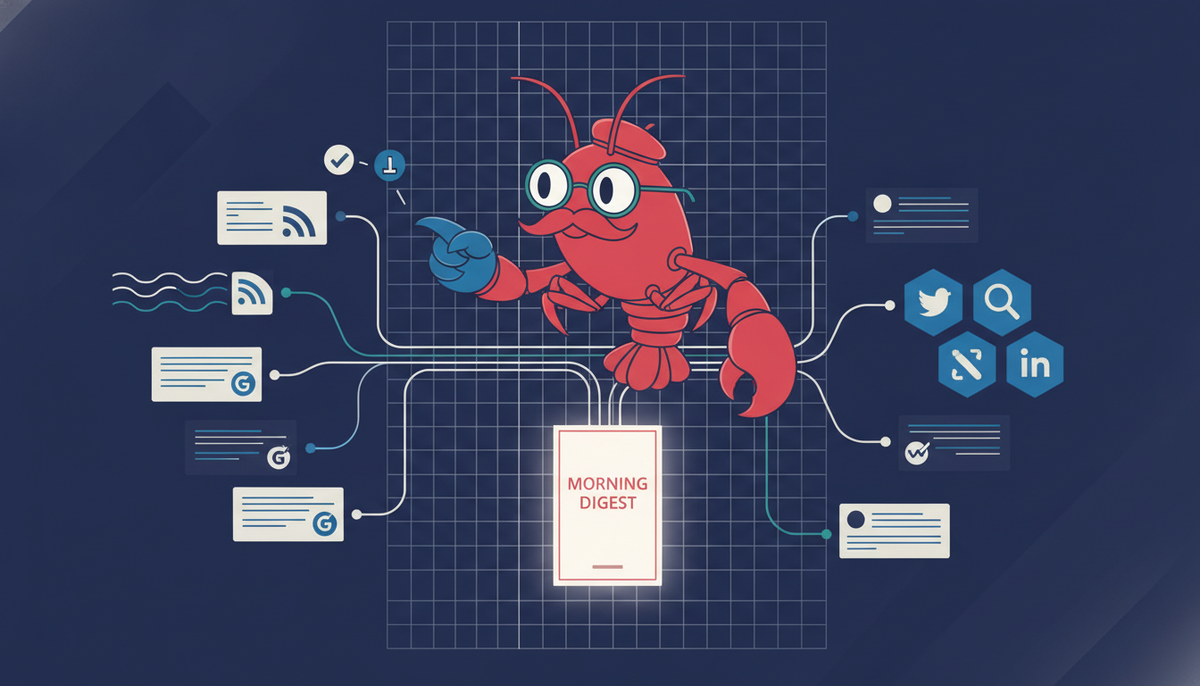
Le dépôt annonce une installation conversationnelle : demander à l’agent d’installer tech-news-digest puis de programmer un digest quotidien à 9 h. Derrière cette promesse courte se cache un pipeline plus classique et, c’est plutôt sain, inspectable : chaque famille de sources est collectée, fusionnée, enrichie de métadonnées puis passée dans des étapes de scoring, de déduplication et de regroupement thématique.
Le cas est réel au sens où le code, la configuration et les tests sont publics ; ce n’est pas un témoignage marketing impossible à vérifier. Il faut toutefois distinguer ce que le dépôt déclare de ce qui est démontré indépendamment. Les 216 sources et l’exécution annoncée « ~30 s » sont des caractéristiques documentées par le mainteneur, pas un benchmark reproduit ici sur une instance LaPince.
La partie intéressante n’est donc pas « l’IA lit Internet ». C’est le choix d’industrialiser les règles de sélection : une source prioritaire compte davantage, un fait recoupé entre plusieurs types de sources monte dans la liste, une actualité fraîche reçoit un bonus, tandis qu’un élément déjà rapporté est pénalisé. On transforme ainsi la veille en système explicable plutôt qu’en simple prompt magique.
🔧 Le Setup Technique
Architecture Agent
Cron OpenClaw (quotidien / hebdomadaire)
        ↓
run-pipeline.py
        ↓
RSS + X + recherche web + releases GitHub + Reddit opt-in
        ↓ (collecte parallèle)
merge-sources.py → enrichissement → score qualité → déduplication
        ↓
regroupement par thèmes → rendu Markdown / e-mail / Discord / PDF
Le projet propose 93 flux RSS, 76 comptes X et 47 dépôts GitHub ; Reddit ajoute 13 communautés mais reste désactivé par défaut. C’est un choix important : les endpoints publics de Reddit sont soumis à des refus et à du rate limiting depuis des IP de serveurs. Pour l’activer, il faut une application OAuth et des identifiants dédiés.
Fichiers clés
Configuration de sources
{
  "sources": [
    {"id": "my-blog", "type": "rss", "enabled": true,
     "url": "https://my-company-blog.com/feed", "topics": ["llm"]},
    {"id": "openai-blog", "enabled": false}
  ]
}
Le mécanisme d’overlay est bien pensé : workspace/config/ surcharge les valeurs par défaut sans obliger à recopier tout le catalogue. C’est la différence entre un starter agréable et un outil maintenable six mois plus tard.
Règles de scoring documentées
source prioritaire : +3 (+2 additionnels pour RSS prioritaire)
recoupement inter-sources : +5 par type de source supplémentaire
moins de 24 h : +2
déjà rapporté : -5
Étapes de mise en place
- Installer le skill dans le workspace OpenClaw :
clawhub install tech-news-digest - Installer les dépendances minimales du pipeline :
pip install -r requirements.txt - Créer une surcharge de sources plutôt que modifier les defaults :
cp config/defaults/sources.json workspace/config/tech-news-digest-sources.json - Ajouter seulement les sources et thèmes qui correspondent au besoin réel, puis demander à OpenClaw de planifier le digest et de choisir le canal de sortie.
- Si la couche Reddit est nécessaire, créer une application « script » Reddit, exporter
REDDIT_CLIENT_IDetREDDIT_CLIENT_SECRET, puis réactiver explicitement les sources concernées. Sans ces clés, mieux vaut laisser cette couche coupée.
Les tokens X, Brave/Tavily et GitHub restent optionnels : le pipeline dégrade ses capacités selon les accès disponibles. Cette souplesse évite de bloquer l’installation, mais elle impose de contrôler la couverture effective dans les premiers rapports.
📊 Les Résultats
Gains mesurés ou annoncés par le projet :
- 216 sources intégrées : 93 RSS, 76 comptes X, 47 dépôts GitHub, auxquels s’ajoutent 13 subreddits opt-in et 4 requêtes web.
- 6 couches de collecte dans le pipeline, avec des collectes parallèles.
- Environ 30 secondes annoncées pour
run-pipeline.pydans la documentation du dépôt. - Un plafond éditorial hebdomadaire de 35 items uniques et 10 000 caractères : ce n’est pas un KPI de temps gagné, mais un garde-fou mesurable contre le digest interminable.
Limites rencontrées :
- Les chiffres viennent du README du mainteneur. Le dépôt ne publie pas de benchmark reproductible avec machine, latence par connecteur et taux de déduplication.
- Les données X et Reddit ne sont pas « gratuites » : elles requièrent respectivement un backend/API compatible et des credentials OAuth. Une veille sans budget ni clés ne couvre donc pas le même périmètre.
- Une déduplication par similarité de titres réduit le bruit, mais peut écraser deux angles réellement distincts sur le même événement.
🧐 Analyse critique
✅ Ce qui est bien fait
- La hiérarchie des sources est déclarative. On peut relire et modifier les règles de scoring au lieu de subir une sélection opaque du modèle.
- La configuration par overlay protège les mises à jour. Ajouter un flux maison ne transforme pas chaque upgrade du skill en conflit de fichiers.
- Le projet assume la contrainte des connecteurs. Reddit est désactivé par défaut et les variables d’environnement sont documentées ; c’est nettement plus honnête qu’une promesse de collecte universelle.
⚠️ Points d’attention
- Le score n’est pas une vérité éditoriale. Un bonus de recoupement favorise les annonces déjà reprises partout. Les signaux faibles peuvent rester bas dans le classement.
- Les clés API sont une surface sensible. Elles doivent vivre dans le gestionnaire de secrets de l’environnement, jamais dans
workspace/config/, un prompt ou un dépôt Git. - La livraison automatique mérite une étape de revue. Pour un canal public, envoyer directement une synthèse générée expose aux erreurs de source, aux titres trompeurs et aux liens mal attribués.
💡 Améliorations possibles
- Ajouter une passe de validation humaine ou un canal « brouillon » avant la diffusion externe, avec les sources affichées pour chaque assertion.
- Mesurer les résultats localement : taux de doublons supprimés, temps de revue, liens ouverts et éléments réellement retenus. C’est plus utile que de compter les sources disponibles.
- Mettre en place une liste de « signaux rares » : petits dépôts, changelogs précis et auteurs experts, afin qu’ils ne soient pas noyés par la popularité.
🎓 Ce qu’on en retient
Leçons clés :
- Un bon agent de veille a besoin de règles de sélection, d’un état des éléments déjà traités et d’un format de sortie borné — pas seulement d’un accès au web.
- Commencer avec peu de sources très fiables, puis élargir après avoir mesuré le bruit, est plus robuste que d’activer un catalogue de 216 sources le premier jour.
- L’automatisation doit accélérer la préparation ; la décision de publier reste une responsabilité éditoriale, surtout lorsque le digest part vers des lecteurs.
Pour aller plus loin :
- Produire une revue IA avec OpenClaw
- Surveiller l’IA avec OpenClaw
- Source originale : Tech News Digest
- Référencement du cas dans Awesome OpenClaw Use Cases
À dimanche prochain pour un nouveau cas ! 🦞