Surveiller l'IA avec OpenClaw : Cas Réel Research
Avant : trois sources IA a verifier a la main. Apres : un signal Telegram toutes les 4h. Comment shoripanda a automatise sa veille technique avec OpenClaw.

Bon dimanche ! ☕
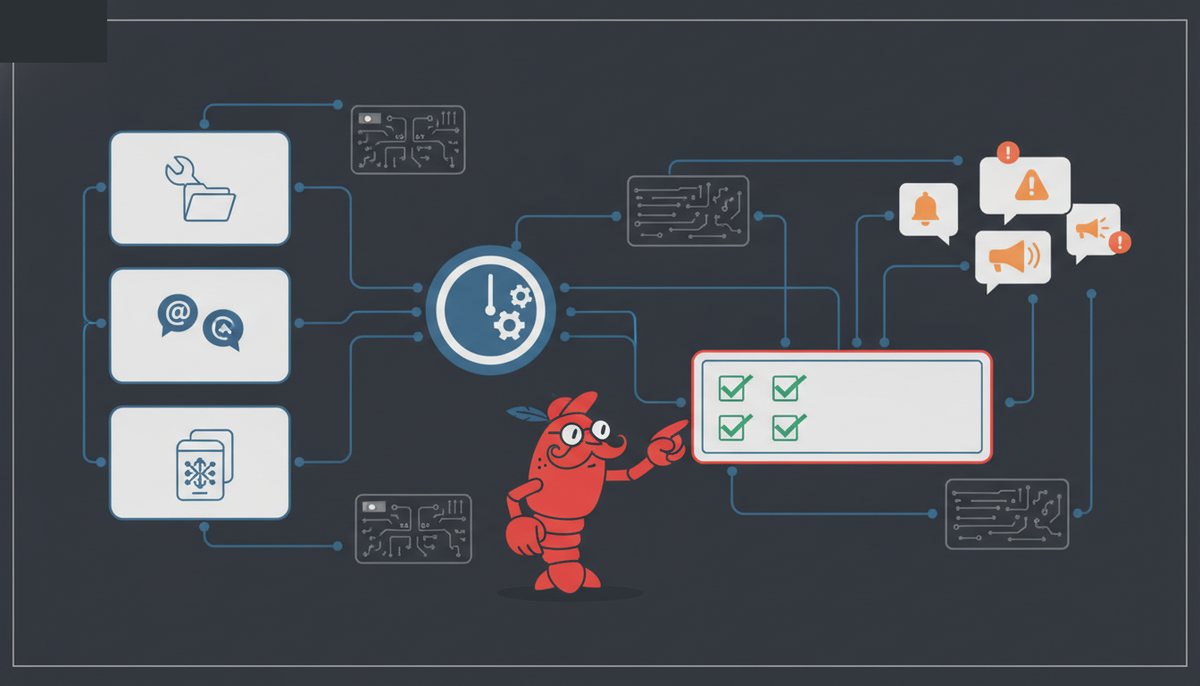
Aujourd'hui, on plonge dans un cas discret mais tres utile : une veille IA qui tourne toute seule, surveille plusieurs sources techniques, evite les doublons, puis envoie seulement les nouveautes dans Telegram.
Ce n'est pas le cas le plus spectaculaire de l'annee. Justement : il est interessant parce qu'il ressemble a un vrai workflow de terrain. Un petit systeme, pas trop magique, documente dans un repo public, avec les pieges d'installation notes noir sur blanc.
🎯 Le Cas : Veille IA Multi-Sources
Auteur : shoripanda (source GitHub)
Contexte : utilisateur qui documente des automations construites avec OpenClaw et publie les configurations reproductibles.
Objectif : surveiller GitHub, Hacker News et Hugging Face sur des mots-cles IA, puis notifier Telegram uniquement quand un nouvel element pertinent apparait.
📖 L'Histoire
Le point de depart est classique pour tous ceux qui suivent l'IA de pres : les signaux utiles sont eparpilles. Un repo apparait sur GitHub, une discussion remonte sur Hacker News, un modele sort sur Hugging Face, puis tout disparait dans le bruit si personne ne regarde au bon moment.
Le repo openclaw-automations rassemble plusieurs workflows construits avec OpenClaw ou autour de lui. Celui qui nous interesse ici s'appelle keyword-monitor. Son ambition est volontairement limitee : prendre une liste de mots-cles, interroger trois sources a intervalle regulier, memoriser ce qui a deja ete vu, et pousser les nouveautes dans Telegram.
Cette sobriete est une force. Beaucoup de projets d'agents s'effondrent sur des details banals : doublons, secrets mal geres, notifications trop nombreuses, premier run qui inonde le canal, ou differences entre CLI et interface. Ici, ces problemes sont traites directement.
Le README raconte aussi les irritants rencontres pendant la mise en place : npm 11 qui met en attente certains builds natifs, l'import CLI n8n qui casse si le workflow n'a pas d'id top-level, le trigger planifie qui ne se lance pas comme une execution manuelle, ou encore Telegram qui peut timeout via fetch a cause d'IPv6 alors que curl ou le httpRequest de n8n passent. Ce sont de petits details, mais ce sont souvent eux qui separent une demo d'un outil qui tourne vraiment.
🔧 Le Setup Technique
Architecture Agent
Le schema mental est simple :
OpenClaw / agent de veille
  -> conception et iteration du workflow
  -> n8n Schedule Trigger toutes les 4 heures
  -> Code node unique
  -> GitHub Search API
  -> Hacker News Algolia API
  -> Hugging Face Models API
  -> getWorkflowStaticData pour les IDs deja vus
  -> Telegram Bot API
Le workflow n8n contient seulement deux noeuds : un trigger planifie toutes les 4 heures et un noeud Code. Toute la logique vit dans monitor.code.js, facile a lire, copier et modifier.
La liste de mots-cles surveilles est courte :
const KW = [
  "abliterated",
  "uncensored LLM",
  "Claude Code",
  "Codex",
  "coding agent",
  "LLM agent",
  "MCP",
  "GLM"
];
Chaque source a son filtre :
- GitHub cherche dans nom, description et README, avec
stars:>30, trie par mise a jour recente et limite a 5 resultats par mot-cle. - Hacker News passe par Algolia, cherche les stories recentes et garde les resultats au-dessus de 20 points.
- Hugging Face interroge l'API models, trie par date de creation et limite a 5 modeles par mot-cle.
Fichiers Clés
README.md
Schedule toutes les 4 heures -> un seul Code node.
Chaque source est recherchee par mot-cle.
getWorkflowStaticData conserve les IDs deja vus.
Le premier run seed seulement les resultats existants.
Les notifications partent via Telegram Bot API.
.env.example
TG_BOT_TOKEN=123456:your-telegram-bot-token
TG_CHAT_ID=000000000
monitor.code.js
const staticData = $getWorkflowStaticData('global');
const seen = staticData.seen || {};
const firstRun = !staticData.seeded;
const out = [];

const mark = (id) => {
  if (seen[id]) return false;
  seen[id] = Date.now();
  return true;
};
Le choix important est ici : mark() enregistre chaque ID rencontre. Au premier lancement, le workflow marque les elements deja presents comme lus, mais ne les envoie pas. A partir du deuxieme passage, seuls les nouveaux IDs produisent une notification.
workflow.json
{
  "name": "キーワード監視 (GitHub/HN/HF → Telegram)",
  "nodes": [
    { "name": "4時間ごと", "type": "n8n-nodes-base.scheduleTrigger" },
    { "name": "監視&通知", "type": "n8n-nodes-base.code" }
  ],
  "active": false
}
Étapes de Mise en Place
- Installer ou lancer n8n :
npm i -g n8n
n8n start
- Cloner le repo :
git clone https://github.com/shoripanda/openclaw-automations.git
cd openclaw-automations/keyword-monitor
- Importer
workflow.jsondans n8n depuis l'interface :
Editor -> Import from File -> workflow.json
- Creer un bot Telegram avec BotFather, puis definir les deux variables :
export TG_BOT_TOKEN="123456:your-telegram-bot-token"
export TG_CHAT_ID="000000000"
- Adapter les mots-cles dans le Code node :
const KW = ["OpenClaw", "MCP", "coding agent", "LLM agent"];
- Executer une premiere fois manuellement depuis l'interface n8n :
Execute workflow
Ce premier passage seed les resultats existants. C'est lui qui evite de recevoir d'un coup tout l'historique GitHub, HN et Hugging Face.
- Publier le workflow dans la nouvelle interface n8n :
Publish
- Surveiller le canal Telegram au passage suivant :
{ "sent": 3 }
Si les notifications sont longues, le script les decoupe en blocs d'environ 3800 caracteres.
📊 Les Résultats
Gains mesurés :
- 3 sources surveillees automatiquement : GitHub, Hacker News et Hugging Face.
- 8 mots-cles suivis dans la configuration publiee.
- 1 execution toutes les 4 heures, soit jusqu'a 6 passages par jour sans intervention humaine.
- 0 notification historique au premier run grace au mecanisme de seed.
- Deduplication persistante via
getWorkflowStaticData, donc pas de renvoi du meme repo, thread ou modele a chaque cycle.
Limites rencontrées :
- Le repo ne publie pas encore de metrique de temps economise avant/apres. On peut mesurer le volume surveille, pas un gain horaire personnel certifie.
- L'etat
seende n8n est pratique, mais il reste interne au workflow. Pour une veille critique, un export JSON ou SQLite serait plus robuste. - Les erreurs API sont silencieusement ignorees avec
catch (e) {}. C'est acceptable pour un petit moniteur, moins pour une veille editoriale ou commerciale importante. - Telegram depend d'un token bot et d'un chat ID : simple a deployer, mais il faut proteger ces secrets et eviter de les exporter dans
workflow.json.
🧐 Analyse Critique
✅ Ce qui est bien fait
- Le premier run est pense correctement. Beaucoup de moniteurs envoient tout l'historique au demarrage. Ici, le workflow marque d'abord l'existant comme lu, puis commence a notifier seulement les nouveaux elements. C'est exactement le comportement attendu pour une veille durable.
- La deduplication est au bon niveau. Le script stocke des IDs prefixes par source :
gh:,hn:,hf:. Cela evite les collisions et rend le debug plus lisible. - Le systeme reste lisible. Un trigger, un noeud Code, trois APIs publiques, une sortie Telegram. Un lecteur moyen peut comprendre le flux sans apprendre une plateforme entiere.
- Les filtres reduisent le bruit. GitHub impose
stars:>30, HN imposepoints>20, Hugging Face limite les resultats recents. Ce n'est pas parfait, mais c'est mieux qu'une recherche brute. - Les pieges d'installation sont documentes. Les notes sur npm, l'import n8n, le bouton Publish et Telegram IPv6 valent autant que le code : elles evitent de perdre une heure sur des faux problemes.
⚠️ Points d'attention
- Pas d'observabilite en cas d'echec. Les
catchvides empechent de voir si GitHub rate-limite, si HN change son schema, ou si Hugging Face retourne une erreur. Une notification d'erreur resumee, meme rare, serait utile. - La pertinence reste basee sur les mots-cles. Le workflow detecte un signal, il ne le qualifie pas vraiment.
- Le stockage interne est fragile a long terme.
getWorkflowStaticDataconvient pour un workflow personnel, mais il n'offre pas la portabilite d'un fichier versionne ou d'une petite base externe. - Les seuils sont arbitraires.
stars:>30etpoints>20filtrent le bruit, mais peuvent manquer des projets recents importants. Pour une veille de niche, il faut parfois accepter des signaux faibles.
💡 Améliorations possibles
- Ajouter une deuxieme etape OpenClaw qui relit les liens detectes, classe chaque signal par pertinence, et produit un court digest au lieu d'une simple alerte brute.
- Remplacer les
catchsilencieux par un compteur d'erreurs par source, envoye une fois par jour si quelque chose casse. - Externaliser l'etat
seendansdata/seen.jsonou SQLite pour faciliter backup, migration et inspection. - Produire un rapport hebdomadaire a partir des notifications Telegram : top repos, tendances recurrentes, modeles Hugging Face marquants, threads HN a lire.
🎓 Ce qu'on en retient
Leçons clés :
- Une bonne automation de veille commence par l'anti-doublon et le comportement du premier run. Sans ca, le canal de notification devient vite inutilisable.
- OpenClaw est puissant quand il aide a concevoir, maintenir et enrichir un workflow simple, pas seulement quand il orchestre une armee d'agents.
- Pour passer d'un moniteur personnel a un outil editorial, il manque surtout deux briques : observabilite des erreurs et qualification semantique des resultats.
Pour aller plus loin :
- Produire une Revue IA avec OpenClaw : Cas Réel Média
- Industrialiser ses Workflows avec OpenClaw : Cas Réel DevOps
- Source originale
À dimanche prochain pour un nouveau cas ! 🦞