Valider sa Veille Sociale avec OpenClaw : Cas Réel Marketing
Avant : surveiller trois flux IA a la main. Après : brouillons prêts, validation matinale, posts approuvés seulement. Le setup OpenClaw de shoripanda.
Bon dimanche ! Cafe chaud, workflow bien cable, et cas concret au menu.
Aujourd'hui, on regarde une automatisation qui a le bon niveau de realisme : pas une demo "hello world", pas un agent magique qui poste tout seul dans le vide, mais une chaine de veille, generation, validation humaine et publication sociale. Le projet vient du depot public shoripanda/openclaw-automations, qui documente plusieurs workflows construits avec OpenClaw et gardes comme base reproductible.
🎯 Le Cas : Veille X semi-automatique
Auteur : shoripanda
Contexte : un compte X technique, @reposapo, qui veut publier regulierement sur Claude Code, Codex et les LLM "uncensored/abliterated", sans transformer la veille en spam automatique.
Objectif : collecter deux fois par jour les signaux pertinents, generer des brouillons courts, puis ne publier que les posts approuves le matin.
📖 L'Histoire
Le probleme de depart est tres courant : une veille sociale utile demande de la regularite, mais la regularite finit vite par manger l'attention. Les sources bougent a des rythmes differents. X, lui, recompense la fraicheur, mais penalise vite les posts vagues, repetitifs ou exageres.
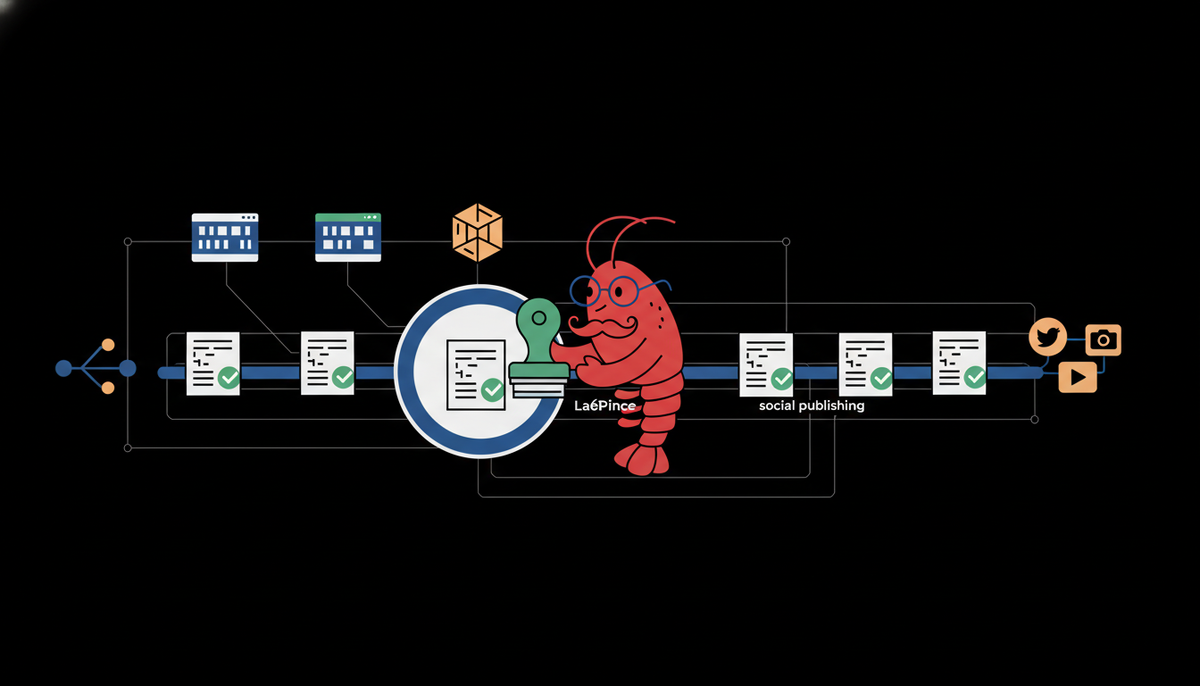
Le workflow reposapo-3themes part de ce terrain-la. L'auteur ne cherche pas a "remplacer" l'editeur du compte X. Il cherche a separer trois operations : collecter les signaux, produire des propositions de posts, puis garder une approbation humaine avant publication. C'est une nuance importante. Beaucoup d'automatisations sociales echouent parce qu'elles branchent directement "source detectee" vers "post public". Ici, le pipeline produit une file d'attente, pas une publication immediate.
La premiere version documentee cible trois themes fixes : Claude Code, Codex, et les LLM locaux dits uncensored ou abliterated. Les deux premiers passent par les flux de releases GitHub. Le troisieme passe par l'API Hugging Face, avec un filtre volontaire : tri par trendingScore, mais exclusion des modeles trop faibles via likes>=30. Le but n'est pas de tout aspirer, mais d'eviter les reuploads sans signal et les fiches vides.
Ensuite, le workflow s'insere dans un bot existant, ~/xpost-bot/generate.py. La documentation precise que la logique de queue et de publication n'a pas ete chamboulee : seules des fonctions de collecte et de resume ont ete ajoutees. C'est exactement le genre de decision qu'on aime voir dans un cas reel. Au lieu de rebatir toute la stack parce qu'un agent peut le faire, l'auteur garde l'infrastructure stable et ajoute une couche OpenClaw pour orchestrer les moments ou l'automatisation a de la valeur.
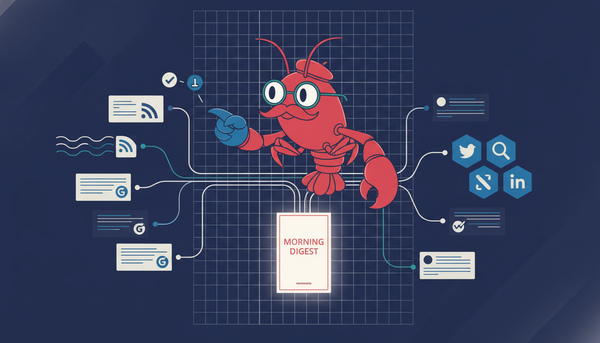
Le resultat final est une boucle quotidienne : collecte a 5h30 et 17h30 heure de Tokyo, presentation d'un plan d'approbation a 6h, puis publication automatique uniquement pour les elements valides.
🔧 Le Setup Technique
Architecture Agent
Sources publiques
  ├─ GitHub releases.atom: anthropics/claude-code
  ├─ GitHub releases.atom: openai/codex
  └─ Hugging Face models API: uncensored / abliterated

OpenClaw automation de collecte
  ├─ cron: 30 5,17 * * * (Asia/Tokyo)
  ├─ session isolated
  ├─ generate.py -> collect_topics()
  ├─ generation: fcc gratuit, fallback Opus
  └─ queue.json: posts pending

OpenClaw automation d'approbation
  ├─ cron: 0 6 * * * (Asia/Tokyo)
  ├─ session main / Telegram
  ├─ plan.py: presente les brouillons du jour
  └─ run_due.py: poste seulement les items approuves
On a donc deux agents temporels, pas un agent omnipotent. Le premier collecte et prepare. Le second remet les brouillons dans un flux de decision.
Fichiers Clés
README du workflow
- Introduit le 2026-09-01
- Compte cible : X @reposapo
- Flux : approbation avant publication automatique
- Deux automations OpenClaw :
  - collecte a 5:30 et 17:30
  - approbation a 6:00
Filtre Hugging Face
def hf_uncensored(n=12, min_likes=30):
    for kw in ("uncensored","abliterated"):
        url = (
            f"https://huggingface.co/api/models?search={kw}"
            f"&sort=trendingScore&direction=-1&limit={n}"
        )
        ...
        if (m.get("likes", 0) or 0) < min_likes:
            continue
Le detail min_likes=30 est petit, mais crucial. Sans seuil, le bot aurait probablement rempli la queue avec des modeles peu documentes.
Selection des trois themes
def collect_topics():
    picks = []
    news = collect_news()
    for label in ("Claude Code", "Codex"):
        for it in news:
            if it["src"] == label and ("news:" + it["id"]) not in seen:
                picks.append(("news", it))
                break
    for it in hf_uncensored():
        if ("hfunc:" + it["id"]) not in seen:
            picks.append(("uncensored", it))
            break
    return picks
Le pipeline choisit une nouveaute par theme, puis marque les items dans seen. C'est le bon reflexe pour une veille durable : on evite les doublons avant la generation, pas apres avoir deja consomme du temps modele.
Étapes de Mise en Place
- Creer ou reutiliser un bot de publication avec une queue locale.
- Ajouter une fonction de collecte par source : releases GitHub pour Claude Code / Codex, API Hugging Face pour les modeles locaux.
- Ajouter un fichier
seenpour dedoublonner les releases et modeles deja traites. - Generer les brouillons avec un modele peu couteux en premier, puis fallback plus fort si le resume echoue.
- Programmer l'automation OpenClaw de collecte :
openclaw cron create \
  --name reposapo-3themes-collect \
  --schedule "30 5,17 * * *" \
  --timezone Asia/Tokyo \
  --target isolated
- Programmer l'automation d'approbation :
openclaw cron create \
  --name reposapo-morning-approval \
  --schedule "0 6 * * *" \
  --timezone Asia/Tokyo \
  --target main
- Ne publier que les items passes de
pendingaapproved, via le script existant de publication.
Les commandes exactes peuvent varier selon la version OpenClaw. La source publique donne surtout les IDs d'automation, les horaires et les cibles, ce qui suffit pour reproduire l'architecture.
📊 Les Résultats
Gains mesurés :
- 3 themes prioritaires captes a chaque run : Claude Code, Codex, LLM uncensored/abliterated.
- 2 collectes quotidiennes automatisees : 5h30 et 17h30, heure de Tokyo.
- 1 gate d'approbation matinal : seuls les posts valides partent.
- Apres ajustement de ratio, le generateur a produit
done: +7 drafts, tous orientes arXiv dans le test documente.
Limites rencontrées :
- Le proxy gratuit
fccpeut timeout selon les moments ; le workflow prevoit donc un fallbackclaude -p --model claude-opus-4-8. - Le signal Hugging Face est bruyant : les modeles avec likes/downloads a zero polluent vite les resultats.
- Le ratio editorial n'est pas magique : trop de Codex / Claude Code a oblige l'auteur a augmenter la part arXiv via
posts_per_run, et a reduirenews_per_run.
🧐 Analyse Critique
✅ Ce qui est bien fait
- Le gate humain est au bon endroit. L'automatisation fait gagner du temps avant la publication, mais elle ne court-circuite pas la decision publique. Pour un compte X, c'est souvent la difference entre assistant utile et machine a bruit.
- La collecte est thematique, pas opportuniste. Trois themes sont fixes et assumés. Le bot ne cherche pas a publier n'importe quel signal IA du jour ; il sert une ligne editoriale reconnaissable.
- Le systeme degrade proprement. Quand le modele gratuit tombe, le fallback Opus evite de casser toute la chaine. Le seuil
likes>=30reduit aussi le bruit HF. - Les changements restent localises. La documentation insiste sur le fait que la queue et la logique de publication existantes ne sont pas reecrites. C'est une bonne hygiene d'automatisation : on modifie la piece qui manque, pas tout le systeme.
⚠️ Points d'attention
- Un seuil de likes n'est pas une preuve de qualite. Il filtre les dechets les plus evidents, mais il peut laisser passer des modeles populaires pour de mauvaises raisons.
- La generation sociale amplifie facilement les formulations trop sures. Le prompt mentionne "faits uniquement" et "pas d'exageration", mais le controle final reste necessaire.
- Les horaires sont adaptes au contexte japonais. Pour un autre public, la collecte 5h30/17h30 et l'approbation 6h peuvent etre parfaites ou totalement decalees. La reproductibilite demande de recalibrer le fuseau et le rythme editorial.
- Le systeme depend de fichiers locaux.
queue.json,seen,config.jsonet les backups manuels sont simples et efficaces, mais il faut surveiller les corruptions, les conflits d'ecriture et les restaurations.
💡 Améliorations possibles
- Ajouter une etape de scoring explicite avant mise en queue : nouveaute, pertinence pour l'audience, risque de hype, presence de source primaire.
- Journaliser chaque decision d'approbation/refus pour comprendre, apres deux semaines, quels themes produisent vraiment de bons posts.
- Ajouter un mode "dry run digest" qui envoie chaque matin les trois meilleurs signaux sans generer de posts, utile pendant une phase de calibrage.
🎓 Ce qu'on en retient
Leçons clés :
- Une bonne automatisation sociale ne supprime pas forcement l'approbation humaine ; elle rend l'approbation plus rapide et mieux informee.
- Les filtres simples, comme
seenetlikes>=30, valent mieux qu'une grosse promesse agentique sans garde-fous. - OpenClaw est particulierement interessant quand il orchestre le temps : collecte a heure fixe, validation dans le bon canal, action publique seulement apres decision.
Pour aller plus loin :
- Produire une Revue IA avec OpenClaw : Cas Réel Média
- Surveiller l'IA avec OpenClaw : Cas Réel Research
- Source originale
À dimanche prochain pour un nouveau cas ! 🦞